Lecție gratuită · De ce inventează și cum îl legi de realitate
De ce inventează: mecanica halucinației
Din cursul RAG: dă-i AI-ului datele tale, 20 lecții. O poți citi întreagă, fără cont.
Ai pus o întrebare unui asistent AI și ai primit un răspuns care suna impecabil și era fals. Un articol de lege care nu există, un termen de garanție inventat, o cifră plauzibilă și greșită. Nu e o defecțiune rară. E felul în care funcționează lucrul ăsta.
Ca să repari problema, trebuie mai întâi să înțelegi de unde vine. Altfel cumperi soluții care nu ating cauza.
Modelul nu caută nimic, alege cuvântul următor
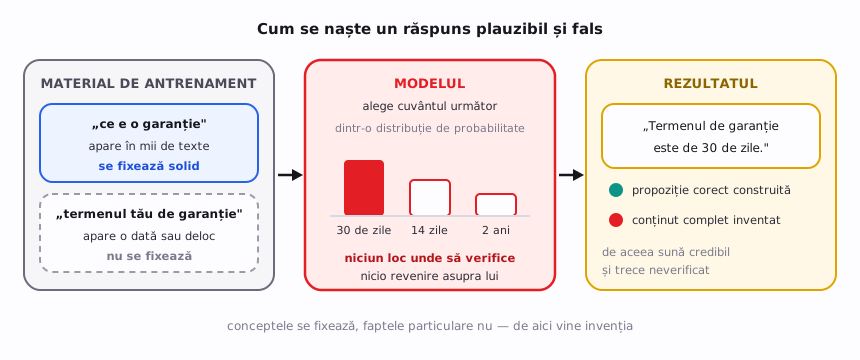
Un model de limbaj nu are un sertar în care stă răspunsul și din care îl scoate. Produce text bucată cu bucată, alegând de fiecare dată continuarea cea mai probabilă pe baza a ceea ce a citit la antrenament. Nu are unde să verifice și nu are cum să-și revadă răspunsul înainte să ți-l dea.
Aici apare o asimetrie pe care puțini o știu: conceptele se fixează, faptele particulare nu. Ce înseamnă o garanție e explicat în zeci de mii de texte, deci modelul a văzut ideea repetat și o stăpânește. Termenul exact din politica ta de garanție apare o dată, sau niciodată. La fel datele calendaristice, cifrele, numele rare. De asta modelele explică bine și rețin prost.
Peste asta se adaugă faptul că materialul de antrenament conține și informații contradictorii. Când modelul alege, alege dintr-o distribuție în care coexistă și varianta corectă, și cea greșită.
Două feluri de invenție, cu tratament diferit
- Halucinația de fapt contrazice realitatea verificabilă. Modelul îți spune că legea prevede ceva ce nu prevede.
- Halucinația de fidelitate contrazice materialul sau instrucțiunea pe care i le-ai dat tu. I-ai pus contractul sub nas și îți răspunde ceva ce nu scrie în contract.
Deosebirea contează pentru tot restul cursului. Ce vei construi aici taie masiv prima categorie. Pe a doua o reduce, dar nu o elimină — un model poate primi textul corect și tot să extragă din el altceva, mai ales când contextul e lung sau conține informații care se bat cap în cap.
Atenție
Două reglaje pe care le controlezi tu înrăutățesc lucrurile. Primul: „temperatura", adică butonul de creativitate — cu cât e mai sus, cu atât modelul alege mai des variante puțin probabile. Al doilea: cererea de text lung. Cu cât îi ceri să scrie mai mult, cu atât are mai mult gol de umplut, și îl umple.
Cel mai rău e exact în domeniul tău
Un model e antrenat pe un munte de text general. Performanța lui e optimizată pe cunoaștere generală, nu pe nișa ta. Contabilitatea românească, protocolul tău intern de retur, regulamentul unei case de asigurări — acolo modelul are cel mai puțin material și cea mai mare încredere nejustificată.
Și, ca să închidem o iluzie frecventă: un model mai mare halucinează mai puțin, dar nu se oprește. Nu e o problemă care se rezolvă așteptând generația următoare.
Reține
Modelul nu minte. Ca să minți, trebuie să știi adevărul. El produce ce e plauzibil. Sarcina ta nu e să-l faci sincer, ci să-i pui adevărul sub nas la fiecare întrebare. Despre cum se face asta e tot cursul.
Ce nu rezolvă problema
„Îi spun în prompt să nu inventeze" ajută puțin și nu atinge mecanismul. „Îi dau tot documentul odată cu întrebarea" merge pentru un document și cade la trei sute. „Îl reantrenăm pe datele noastre" costă și trebuie refăcut la fiecare modificare — discutăm pe larg în lecția 1.4.
Exercițiu
Alege acum corpul de documente pe care vei lucra tot cursul. Nu teoretic: un teanc real din firma ta, la care ai acces — contracte, proceduri interne, fișe de produs, arhiva de răspunsuri către clienți, rapoarte. Notează trei lucruri: câte documente sunt, în ce format există (PDF, Word, pagini de site, e-mailuri) și care sunt cele cinci întrebări pe care le primești cel mai des despre ele. Toate exercițiile de aici înainte lucrează pe teancul ăsta.
Ți-a plăcut lecția?
Restul cursului merge la fel: lecții scrise, pas cu pas.